OpenClaw 记忆:如何沉淀、组织与自动化
发布时间:2026年3月2日
这篇文档回答 3 个问题:为什么要做记忆分层、为什么 Skill 要和记忆联动、为什么必须自动化而不能靠人肉维护。
我们先遇到的不是“记不住”,而是“记了也用不上”
早期最自然的做法,是把经验都塞进一个总文档:会话记录、用户偏好、工具坑、脚本说明全放一起。短期看很省事,但很快会出现 4 个问题:
- 检索命中率下降:历史越多,噪音越大。
- 新旧知识打架:旧结论没失效标记,新结论又插进来了。
- 原始现场丢失:只有结论,没有当时为什么这么做。
- 无法驱动执行:文档只是“知道了”,但系统不会“照着做”。
所以我们后来换了一个思路:不要只建设记忆库,要建设“记忆 → 规则 → 能力”的闭环。
设计思路:把不同类型的信息放到不同层
| 层 | 载体 | 解决的问题 | 设计原则 |
|---|---|---|---|
| 原始层 | memory/daily/ | 保留时间线和现场上下文 | 按时间写,不求优雅,先保真 |
| 知识层 | memory/specialize/ | 让经验能跨任务复用 | 按主题整理,持续更新 |
| 约束层 | MEMORY.md / AGENTS.md / TOOLS.md / SOUL.md | 固化长期偏好、规则和边界 | 只留高价值、低歧义内容 |
| 能力层 | skills/* | 把知识变成可执行工作流 | 能触发、能复用、能落地 |
这 4 层不是并列存档,而是一个演进链路:

为什么不是“全写进 MEMORY.md”
MEMORY.md 很重要,但它不该变成垃圾场。
如果把所有内容都塞进去,模型每次启动都要读一大坨历史,结果通常是两件事:
- 贵:上下文膨胀;
- 慢:真正关键的约束被淹没。
所以我们对 MEMORY 的定位非常克制:
- 放全局偏好,比如沟通语言、工作方式、硬规则;
- 放长期有效决策,比如工具优先级、代码修改约束;
- 不放细碎排查过程,不放临时中间态。
一句话:MEMORY 负责“永远别忘”,daily 负责“先别丢”,specialize 负责“以后还能用”。
记忆和 Skill 的联动,核心是“升级机制”
真正有价值的不是记下一条经验,而是判断它该不该升级。
什么样的内容只记忆,不升 Skill?
- 一次性的故障排查
- 只对某个时间点有效的背景
- 低频、低复用的信息
什么样的内容要升 Skill?
- 已经重复出现 2~3 次以上
- 有明确触发条件(例如“做飞书文档”“读消息历史”“跑长程任务”)
- 有稳定步骤,可以抽象为 SOP
- 用错代价高,值得系统强提醒
也就是说:
记忆解决“知道”,Skill 解决“每次都按正确方式做”。
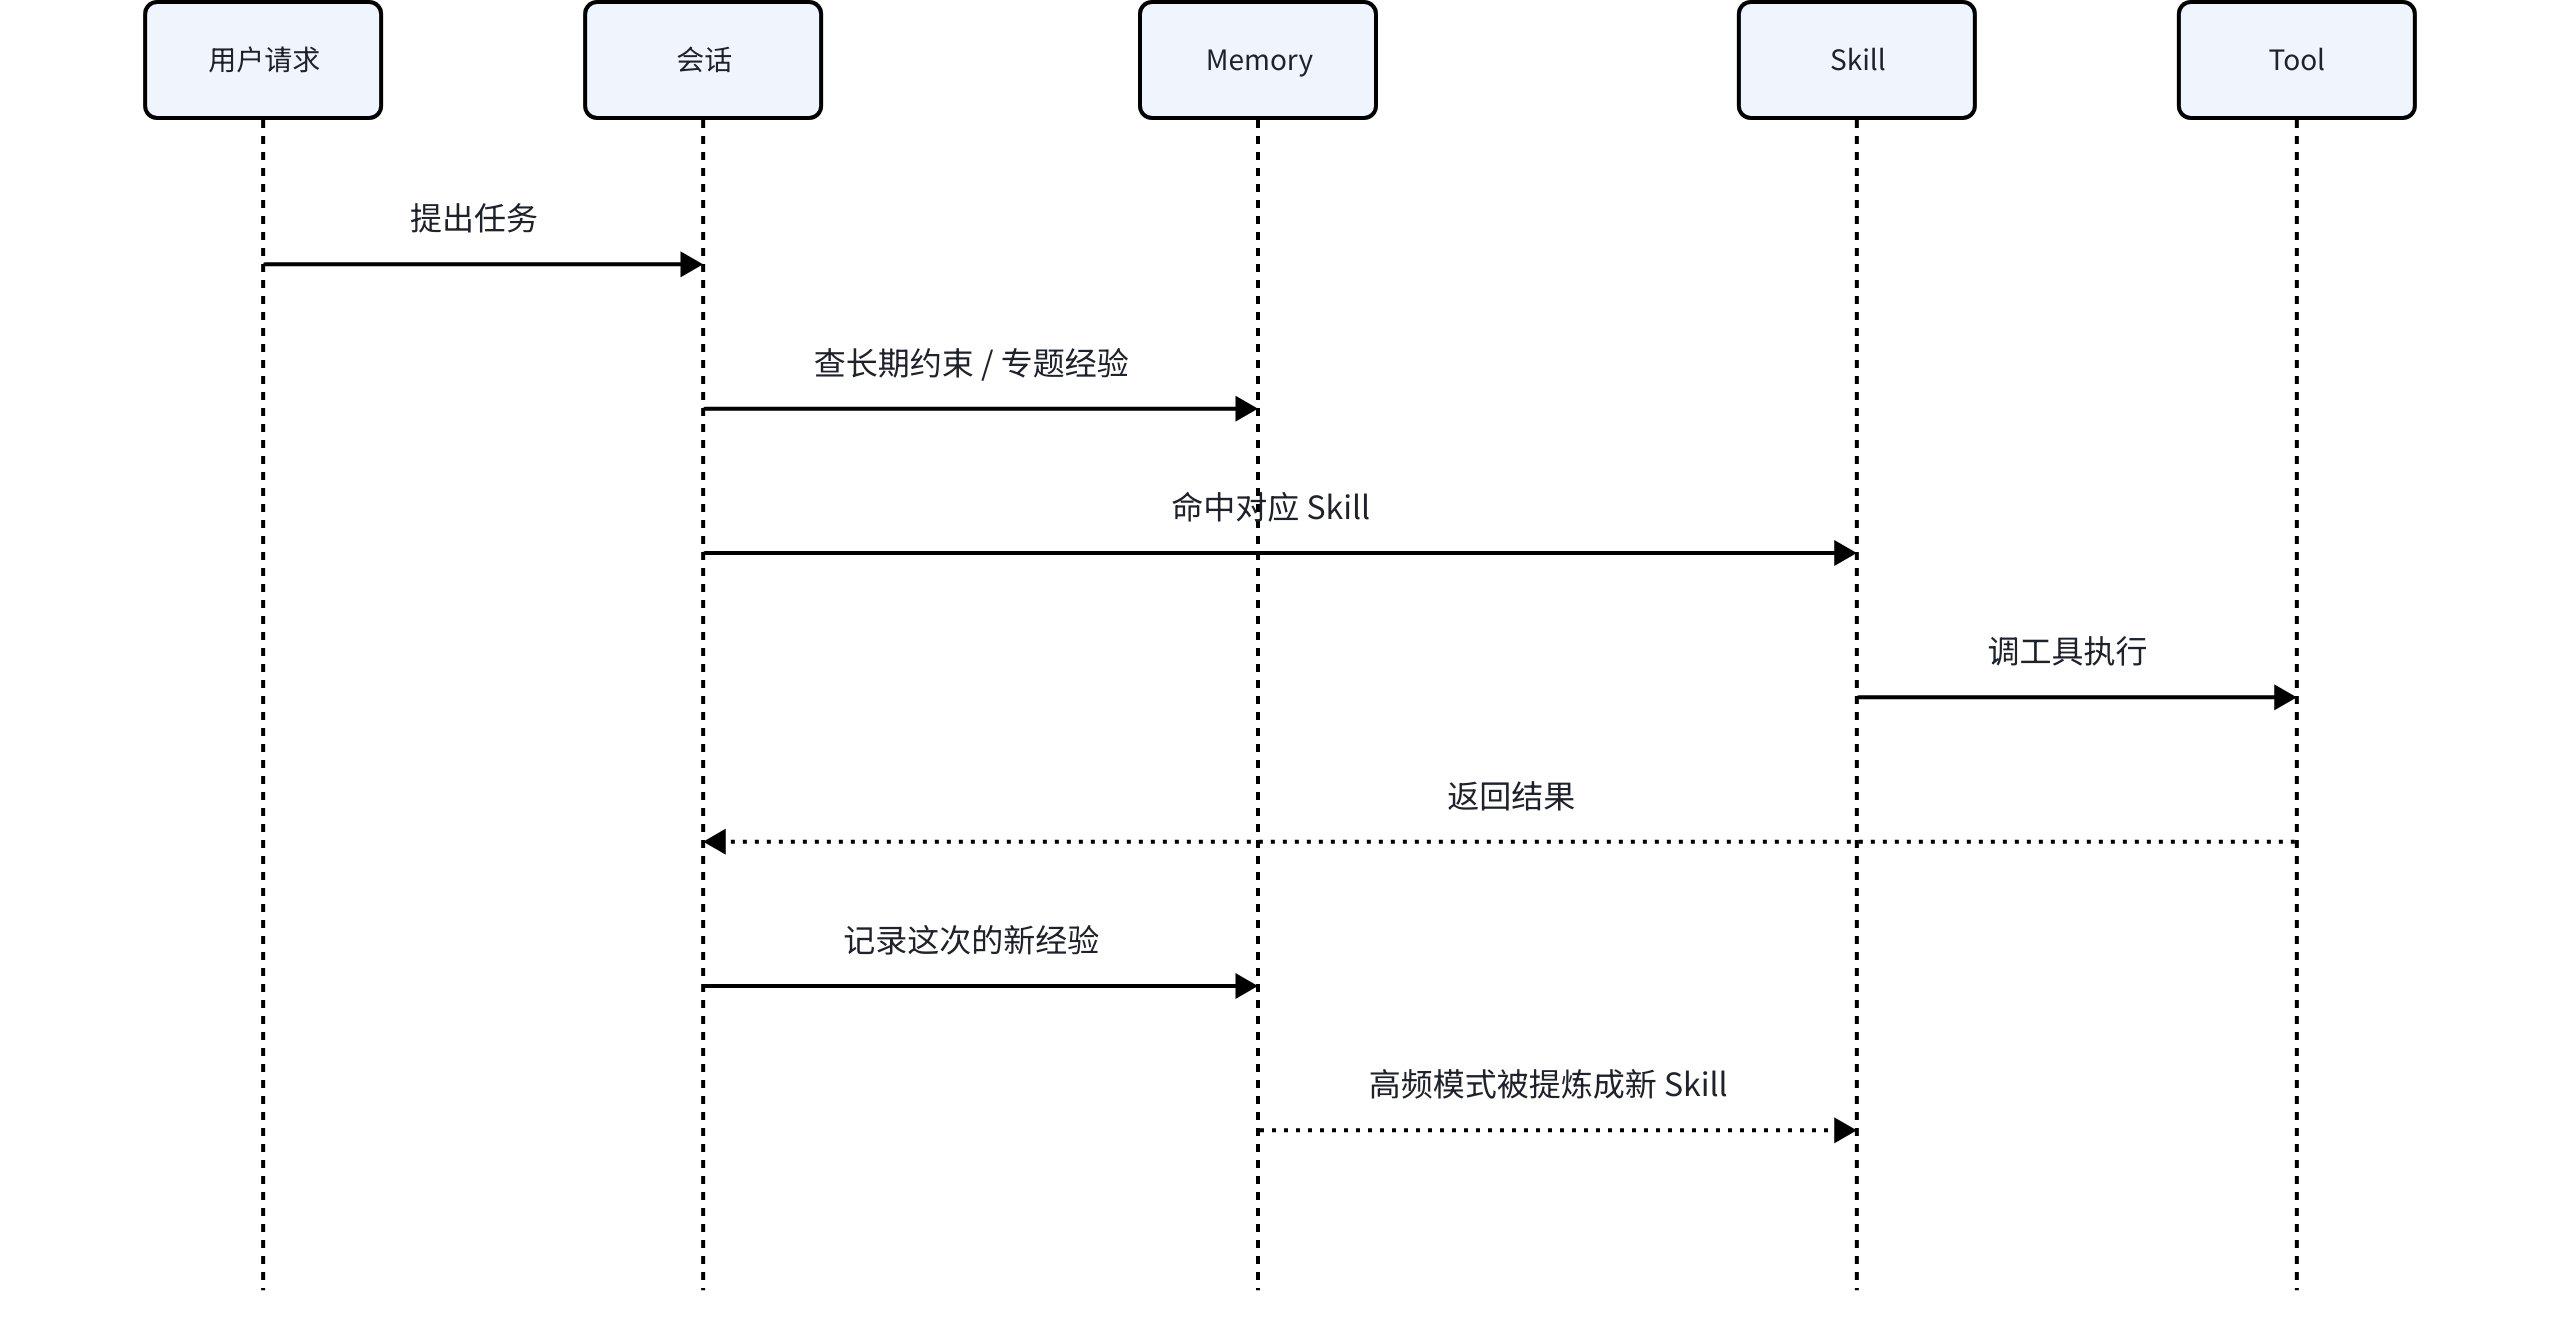
自动化为什么必要
如果没有自动化,体系一定会退化成“想起来才记、忙起来就忘”。
我们现在主要靠 3 类自动化把链路闭上:
会话启动自动注入
会话一开始就读人设、用户偏好、最近记忆。好处是系统不是“裸奔启动”,而是带着约束进入任务。
Hook / Learning Log
当出现报错、用户纠正、发现更好做法时,不停留在“这次知道了”,而是要求落到 learnings,再决定是否晋升到规则文件。
Cron / Review
定时整理 daily,更新索引,把零散记录提炼成专题知识。这样日常记录不会无限堆积成信息沼泽。
这套体系最关键的 trade-off
| 方案 | 优点 | 缺点 | 适用阶段 |
|---|---|---|---|
| 单文档记忆 | 上手快、成本低 | 易臃肿、难复用 | 个人早期 |
| 分层记忆 | 可维护、可检索 | 需要治理成本 | 稳定协作期 |
| 分层记忆 + Skill | 能直接驱动执行 | 设计门槛更高 | 团队化、平台化阶段 |
我们的选择不是因为“更优雅”,而是因为它在长期协作里总成本更低:新增知识可以入层、旧知识可以归档、高频动作可以自动化。
一个最小落地范式
发现新经验后的处理顺序
- 先记到 daily,保证不丢
- 有复用价值 -> 提炼到 specialize
- 反复出现 -> 升级成规则文件或 Skill
- 定时 review,清理过期信息
结论
如果只做记忆,系统会越来越会“回忆”;如果把记忆、规则、Skill 和自动化串起来,系统才会越来越会“做事”。
记忆负责沉淀上下文,规则负责收敛边界,Skill 负责复用动作,自动化负责让这一切持续发生。
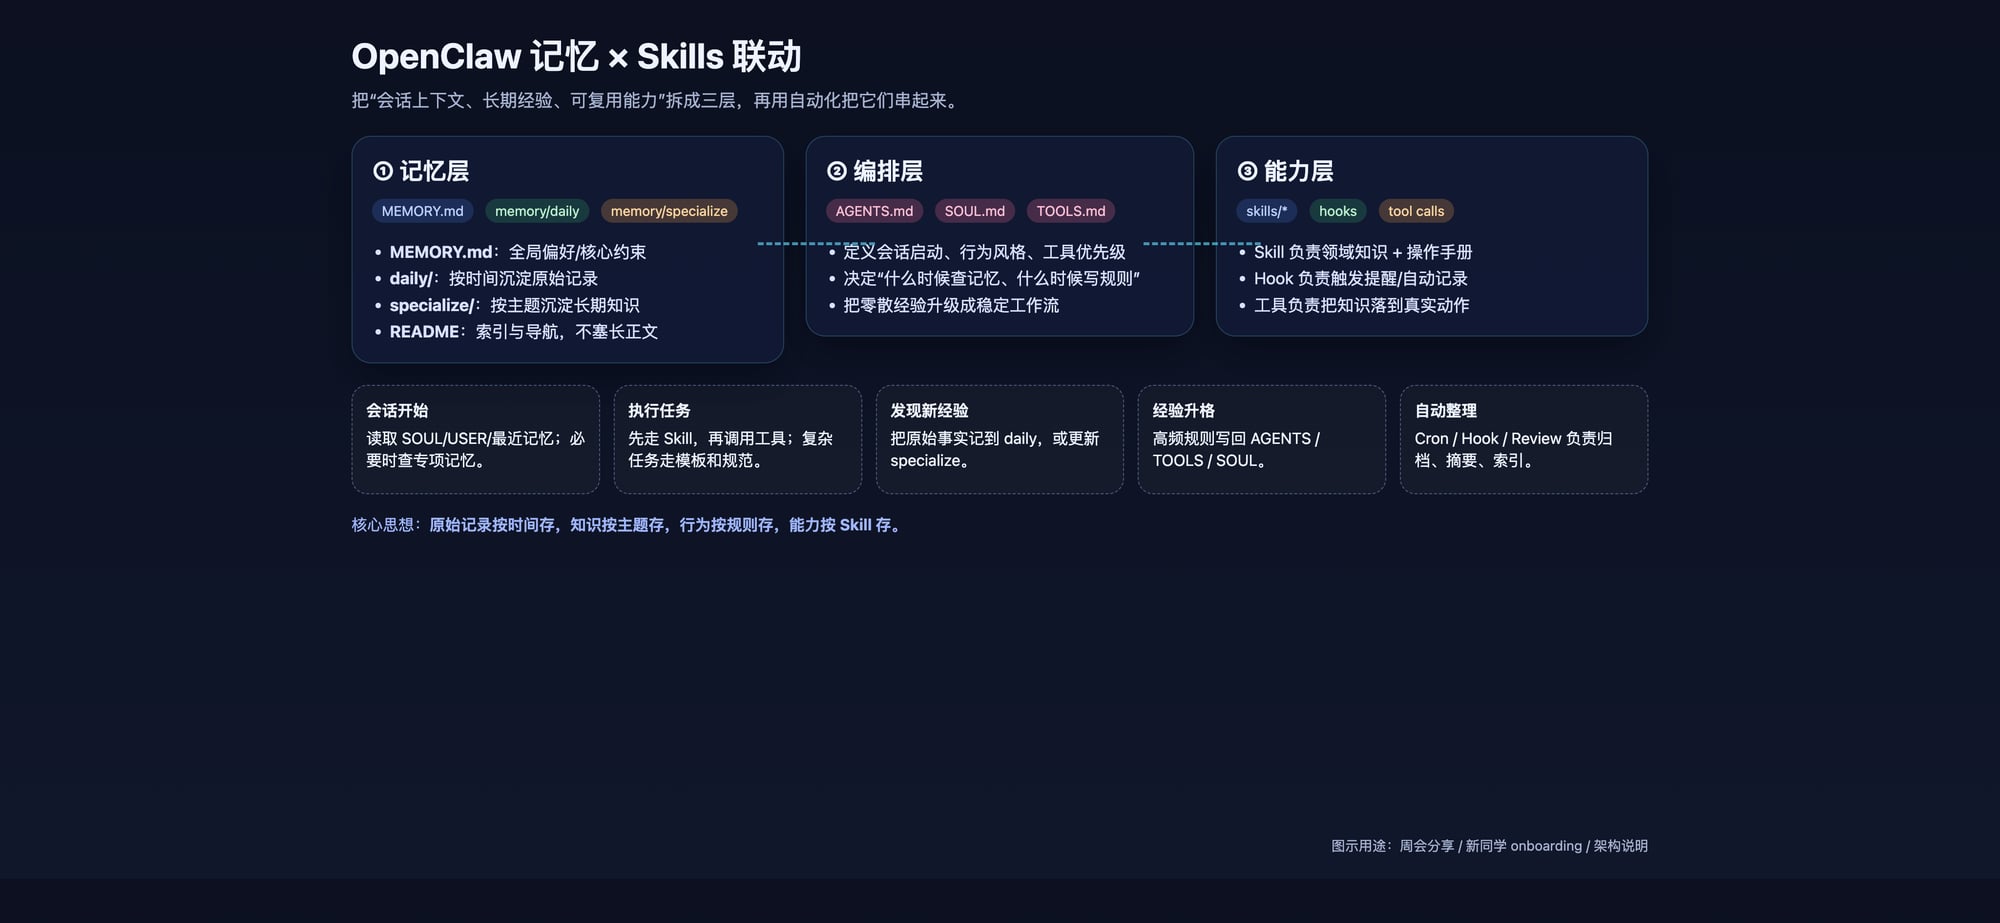
OpenClaw 记忆 × Skills 联动结构图