基于业务切片的 Journey Cases:前端 Agent 的验收闭环
发布时间:2026年4月23日
本文保留 2026-04-23 的用户旅程设计。结合 browser-harness 与 admin 分层测试的新版方案见项目全场景自动化测试套件。
过去一段时间,我们在 Agent 辅助开发上的自动化程度已经比较高了。系分可以拆 slice,任务包可以生成 task,不同类型的页面能力也可以交给对应的 skill 去实现。也就是说,很多前端迭代已经不是“人手工拆任务、人手工写代码”的模式,而是在逐步变成一套可编排的开发流水线。
但开发自动化提高以后,验收反而会变成新的短板。代码可以由 Agent 更快地产出,问题是:它怎么知道自己做完了?人怎么知道这个 slice 真的交付完整了?如果验收仍然停留在临时打开页面看一眼、临时补几个 Playwright 脚本、或者靠测试同学后置评审,那么开发链路越自动化,验收链路里的不确定性就越明显。
所以我们需要的不是零散的测试脚本,而是一套能跟迭代任务一起生成、一起执行、一起沉淀结果的验收方案。
这套方案的核心目标很简单:任务拆出来的时候,验收用例也一起拆出来。Agent 不再是写完代码以后临时想怎么测,而是在 task 阶段就知道这个 slice 应该用哪些 journey cases 验收。
1. Slice、Task、Journey
这套验收方案里,最先确定的不是页面,也不是测试脚本,而是业务 slice。
slice 是一个可以被独立交付和独立验收的业务单元。它通常可以用一句话说清楚:
用户对某个业务对象做了什么操作,系统应该产生什么可观察结果
比如 活动量任务新建/编辑 就可以是一个 slice,因为它有明确的业务对象、用户动作和验收结果:用户填写任务表单,非法提交时不发请求,合法提交后调用创建或更新接口,弹窗关闭,列表刷新,编辑时还能正确回显。
反过来,任务池列表渲染 更像页面实现步骤,接 createActivityTask 接口 更像接口实现步骤。它们都可能是实现工作的一部分,但还不够成为一个独立 slice,因为它们没有完整表达用户目标和验收闭环。
| 维度 | 切分时要看什么 |
|---|---|
| 业务对象 | 是任务池、返佣规则、导入记录,还是某个配置项 |
| 用户动作 | 是查询、新建、编辑、删除、导入,还是保存配置 |
| 主路径 | 用户从哪里开始,怎样完成一次正常操作 |
| 分支路径 | 哪些异常校验、二次确认、编辑回显会影响交付判断 |
| 可观察结果 | 页面状态、请求、payload、列表刷新、字段回显等是否能被验收 |
slice 定下来以后,页面、task、journey 就不是三套材料,而是同一个 slice 的三个视角。
- 页面:这个 slice 落在哪个路由、组件、表单、列表。
- Task:Agent 这次要实现什么、用哪个 skill。
- Journey:用户怎么操作、系统怎么验收。
实际切 slice 时,可以按这几个维度收敛边界:
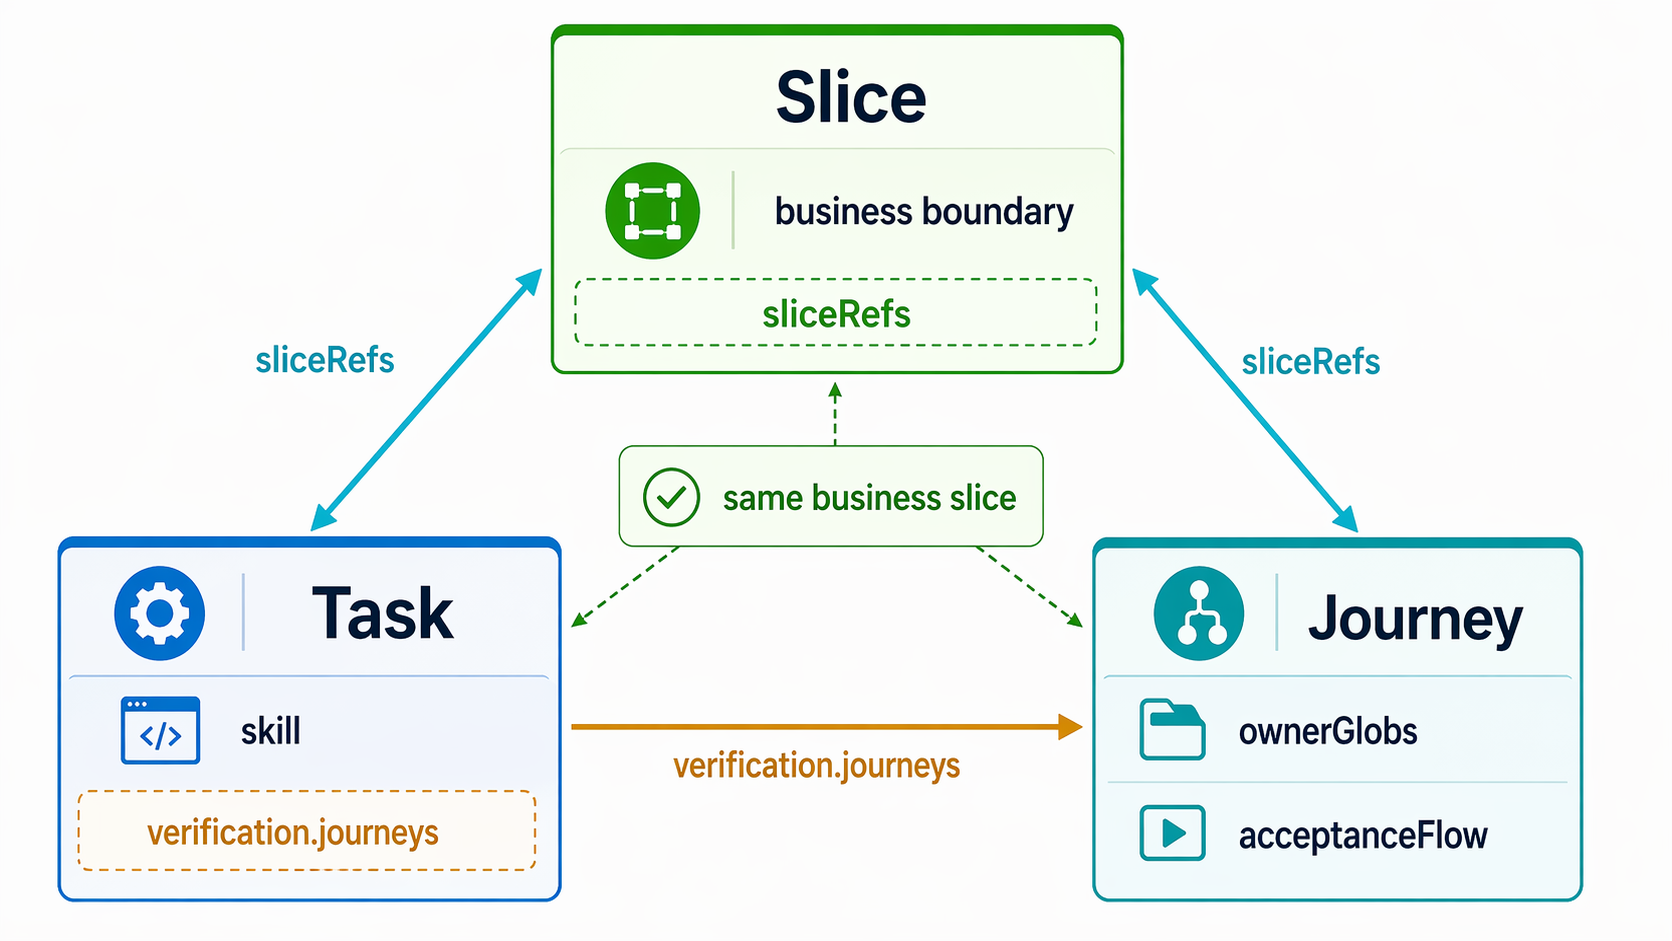
比如 ACT-003 负责活动量任务的新建/编辑,它绑定 SLICE-TP-CREATE-EDIT,同时指向 task-pool-create-edit。
{
  "id": "ACT-003",
  "skill": "building-modal-drawers",
  "sliceRefs": ["SLICE-TP-CREATE-EDIT"],
  "verification": {
    "journeys": ["task-pool-create-edit"]
  }
}
Journey case 里也带同一个 sliceRefs:
{
  "id": "task-pool-create-edit",
  "title": "任务池新建与编辑校验",
  "sliceRefs": ["SLICE-TP-CREATE-EDIT"],
  "ownerGlobs": [
    "src/pages/ActivityManage/TaskPool/components/CreateTaskModal/index.tsx",
    "src/pages/ActivityManage/TaskPool/list/index.tsx"
  ]
}
这就避免了靠标题猜关系。task 和 journey 是通过 slice 明确绑定的。
2. 哪些 Skills 参与 Journey Cases 生成和执行
这条链路可以先简化成这样:
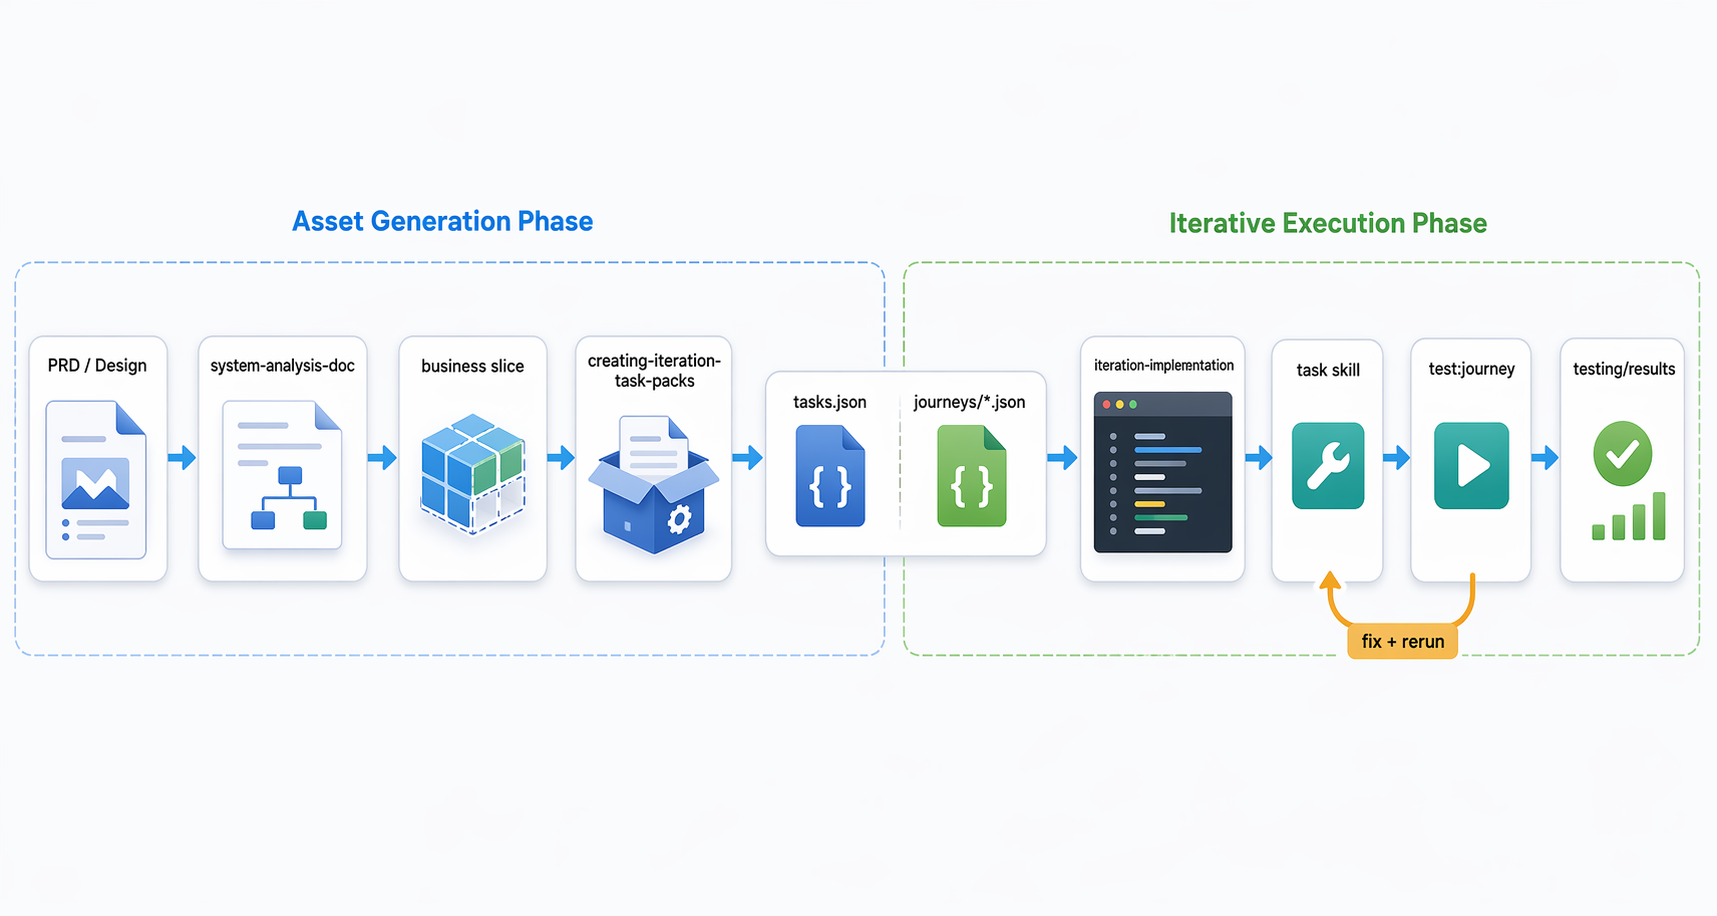

这条链路分两层:前半段负责从需求生成任务和验收资产,后半段负责按 task 做实现、验收、修复和二次验证。这里先只看 Journey Cases 的生成和运行,代码走查、测试用例评审这类旁路审查不放在这张图里。
落到项目里,这条链路主要由几类资产承载:
| 资产 | 作用 |
|---|---|
| 系分里的业务 slice | 定义业务边界、主路径、异常路径和接口观察点 |
iterations/<iteration>/tasks.json |
承载实现任务,记录 skill、sliceRefs、verification.journeys |
testing/iterations/<iteration>/journeys/*.json |
承载用户旅程验收用例 |
testing/runtime/ |
负责读取、执行、断言、写结果 |
.claude/skills/ |
Agent 生成、实现、运行这些资产时使用的工作流 |
| 阶段 | Skill | 主要作用 |
|---|---|---|
| 系分 | system-analysis-doc |
把需求拆成业务 slice |
| 任务包 | creating-iteration-task-packs |
从 slice 生成 tasks 和 journey cases |
| 迭代执行 | iteration-implementation |
从 tasks.json 挑选一个 task,按 task 配置执行实现、验收、修复和二次验证 |
| 实现 | configuring-routes / creating-table-pages / building-modal-drawers / creating-form-pages 等 |
作为 task 的具体实现 skill,落地页面能力 |
| 运行 | running-iteration-tests |
自动拉起 dev server,支持单 task journey 和整迭代 journey 两种运行场景 |
system-analysis-doc 的重点不是列 UI 控件,而是把需求写成可验收的业务行为。比如“用户创建活动量任务,校验失败不发请求,合法提交后调用 create 接口并刷新列表”,这类描述天然能变成 journey。
creating-iteration-task-packs 是拆解的关键。它会生成:
iterations/<iteration>/
  tasks.json
  process.md
  summary.md

testing/iterations/<iteration>/
  manifest.yaml
  journeys/*.json
它做三件事:按 slice 拆 task、给 task 匹配 skill、把验收意图沉到 journey JSON 里。
以 activity-manage-1.0 为例:
| Task | Skill | Journey |
|---|---|---|
ACT-001 |
configuring-routes |
activity-manage-smoke |
ACT-002 |
creating-table-pages |
task-pool-search、task-pool-status-delete |
ACT-003 |
building-modal-drawers |
task-pool-create-edit |
ACT-004 |
building-modal-drawers |
task-pool-import |
ACT-007 |
creating-form-pages |
rebate-rule-config |
任务包生成后,不是直接把所有 journey 一次性跑完。真正的迭代开发闭环由 iteration-implementation 负责:它每次从 tasks.json 里挑一个 task,读取这个 task 的 skill、sliceRefs 和 verification,按对应实现 skill 落地能力,然后调用 running-iteration-tests 跑这个 task 关联的 journey。
如果 journey 没过,回到实现或测试资产修复,再跑一次。这个循环完成后,才继续挑选下一个 task。等单个 task 的闭环都走完以后,running-iteration-tests 还可以不传 --task,按 tasks.json 顺序跑完整个迭代的 journey,做一次迭代级回归。
具体实现类 skills 负责让页面具备业务能力,journey case 负责验证这些能力是否符合 slice 预期。比如 building-modal-drawers 实现弹窗,journey 就验证弹窗打开、表单校验、请求是否发出、payload 是否符合预期。
3. Runtime 怎么理解 Journey JSON
Journey JSON 不是 Playwright 脚本。它表达的是业务验收语义。
| 字段 | Runtime 怎么理解 |
|---|---|
id / title / sliceRefs |
标识这个 journey,并绑定业务 slice |
ownerGlobs |
说明主要覆盖哪些实现文件 |
start |
从哪个页面开始,先做什么初始断言 |
acceptanceFlow |
主路径步骤,按顺序执行 |
branchFlows |
分支路径,比如编辑、删除、异常场景 |
action / intent |
前者是结构化动作,后者是自然语言动作 |
acceptance.request / noRequest |
断言应该发或不应该发的请求 |
payloadIncludes / payloadHasKeys |
验证 payload 的值和字段 |
result |
验证弹窗关闭、列表刷新、字段回显等结果 |
目前 acceptance 主要支持几类维度:
| 维度 | 示例 |
|---|---|
| 页面文本 | 页面标题、关键文案、弹窗标题 |
| 用户动作结果 | 弹窗关闭、列表刷新、字段回显 |
| 请求断言 | 应该发出的 request / requests |
| 负向请求断言 | 不应该发出的 noRequest / noRequests |
| 请求结构 | method、payloadIncludes、payloadHasKeys |
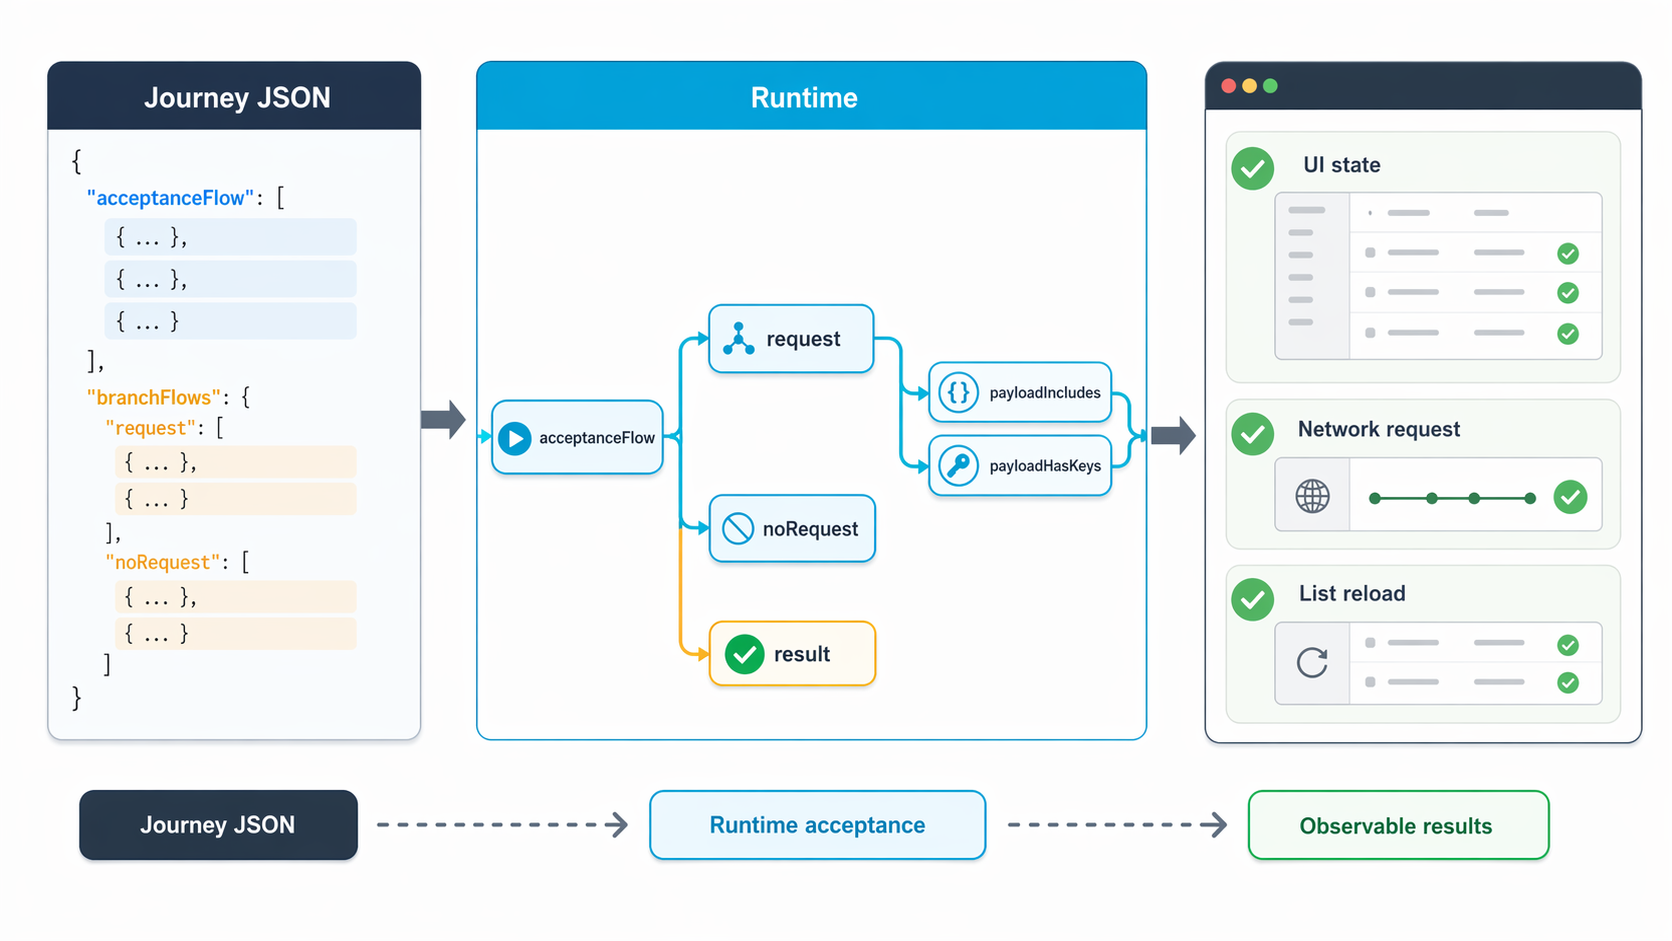
所以写 journey case 的时候,重点不是描述“点第几个按钮”,而是描述这一步应该产生什么业务结果。下面这个例子重点看三类约束:页面状态、请求断言、结果断言。
{
  "version": 1,
  "id": "task-pool-create-edit",
  "title": "任务池新建与编辑校验",
  "sliceRefs": ["SLICE-TP-CREATE-EDIT"],
  "ownerGlobs": [
    "src/pages/ActivityManage/TaskPool/components/CreateTaskModal/index.tsx",
    "src/pages/ActivityManage/TaskPool/list/index.tsx"
  ],

  "start": {
    "page": "activity-task-pool",
    "acceptance": {
      "pageTitle": "任务池",
      "textIncludes": ["活动量名称", "任务状态"]
    }
  },

  "acceptanceFlow": [
    {
      "id": "open-create-dialog",
      "title": "打开新建弹窗",
      "action": {
        "type": "click",
        "target": "primaryCreateEntry"
      },
      "acceptance": {
        "dialogTitle": "新建活动量任务",
        "textIncludes": ["活动量名称", "返佣因子", "完成说明"]
      }
    },
    {
      "id": "invalid-submit",
      "title": "空表单提交校验",
      "action": {
        "type": "click",
        "target": "modalSubmit"
      },
      "acceptance": {
        "textIncludes": ["请输入活动量名称"],
        "noRequest": {
          "api": "ActivityTaskController.createActivityTask"
        }
      }
    },
    {
      "id": "valid-submit",
      "title": "填写表单并提交",
      "intent": "填写活动量任务表单并提交",
      "acceptance": {
        "request": {
          "api": "ActivityTaskController.createActivityTask",
          "method": "POST",
          "payloadIncludes": {
            "activityName": "新客拜访达标",
            "requiredFlag": true
          },
          "payloadHasKeys": [
            "categoryCode",
            "rebateFactorCode",
            "completeDescription"
          ]
        },
        "result": {
          "dialogClosed": true,
          "listReloaded": true
        }
      }
    }
  ],

  "branchFlows": [
    {
      "id": "edit-flow",
      "title": "编辑回显与提交",
      "steps": [
        {
          "id": "open-edit-dialog",
          "action": {
            "type": "click",
            "target": "rowEditEntry"
          },
          "acceptance": {
            "dialogTitle": "编辑活动量任务",
            "result": {
              "fieldValues": {
                "活动量名称": "新客拜访达标"
              }
            }
          }
        },
        {
          "id": "submit-edit",
          "intent": "修改活动量名称并提交编辑表单",
          "acceptance": {
            "request": {
              "api": "ActivityTaskController.updateActivityTask",
              "method": "POST",
              "payloadHasKeys": ["activityCode", "activityName"]
            },
            "result": {
              "dialogClosed": true,
              "listReloaded": true
            }
          }
        }
      ]
    }
  ]
}
压缩一下就是:
metadata 决定选不选它
start 决定从哪里开始
action / intent 决定怎么操作
acceptance 决定怎么判断通过
branchFlows 决定分支怎么展开
4. 为什么要有页面语义配置
如果 journey JSON 里直接写 locator,很快就会变成另一种难维护脚本。所以页面定位知识放到 testing/pages/*.semantic.json。
里面会描述页面路由、页面锚点、工具栏入口、行操作入口、弹窗提交按钮。journey 里只写业务目标:
{
  "type": "click",
  "target": "primaryCreateEntry"
}
至于这个 target 是哪个 button、什么文案、什么 role,由 semantic 文件解释。runtime 大致会按这样的分支去解析:
先根据 start.page 找到页面语义配置
  -> 如果 target 是页面锚点,先确认当前路由和页面关键文案
  -> 如果 target 是工具栏入口,在 toolbar / actions 区域内找按钮或链接
  -> 如果 target 是行操作入口,先定位目标行,再在这一行内找操作按钮
  -> 如果 target 是弹窗操作,先进入当前 dialog / drawer,再找提交、取消、关闭等控件
  -> 如果 semantic 明确给了 selector,就用 selector 做最后兜底
  -> 如果 semantic 给的是 role + name,就按可访问语义找 DOM
  -> 如果只给了 text,就按文本匹配找 DOM
比如 primaryCreateEntry 在 journey 里只是“主新建入口”,semantic 可以把它解释成工具栏里的 button[name=新建];modalSubmit 在 journey 里只是“弹窗提交”,semantic 会先找到当前打开的 dialog,再在 dialog 内找“确定”或“提交”按钮。这样 journey 不需要知道页面用了什么组件结构,也不需要关心按钮最终渲染在哪一层 DOM。
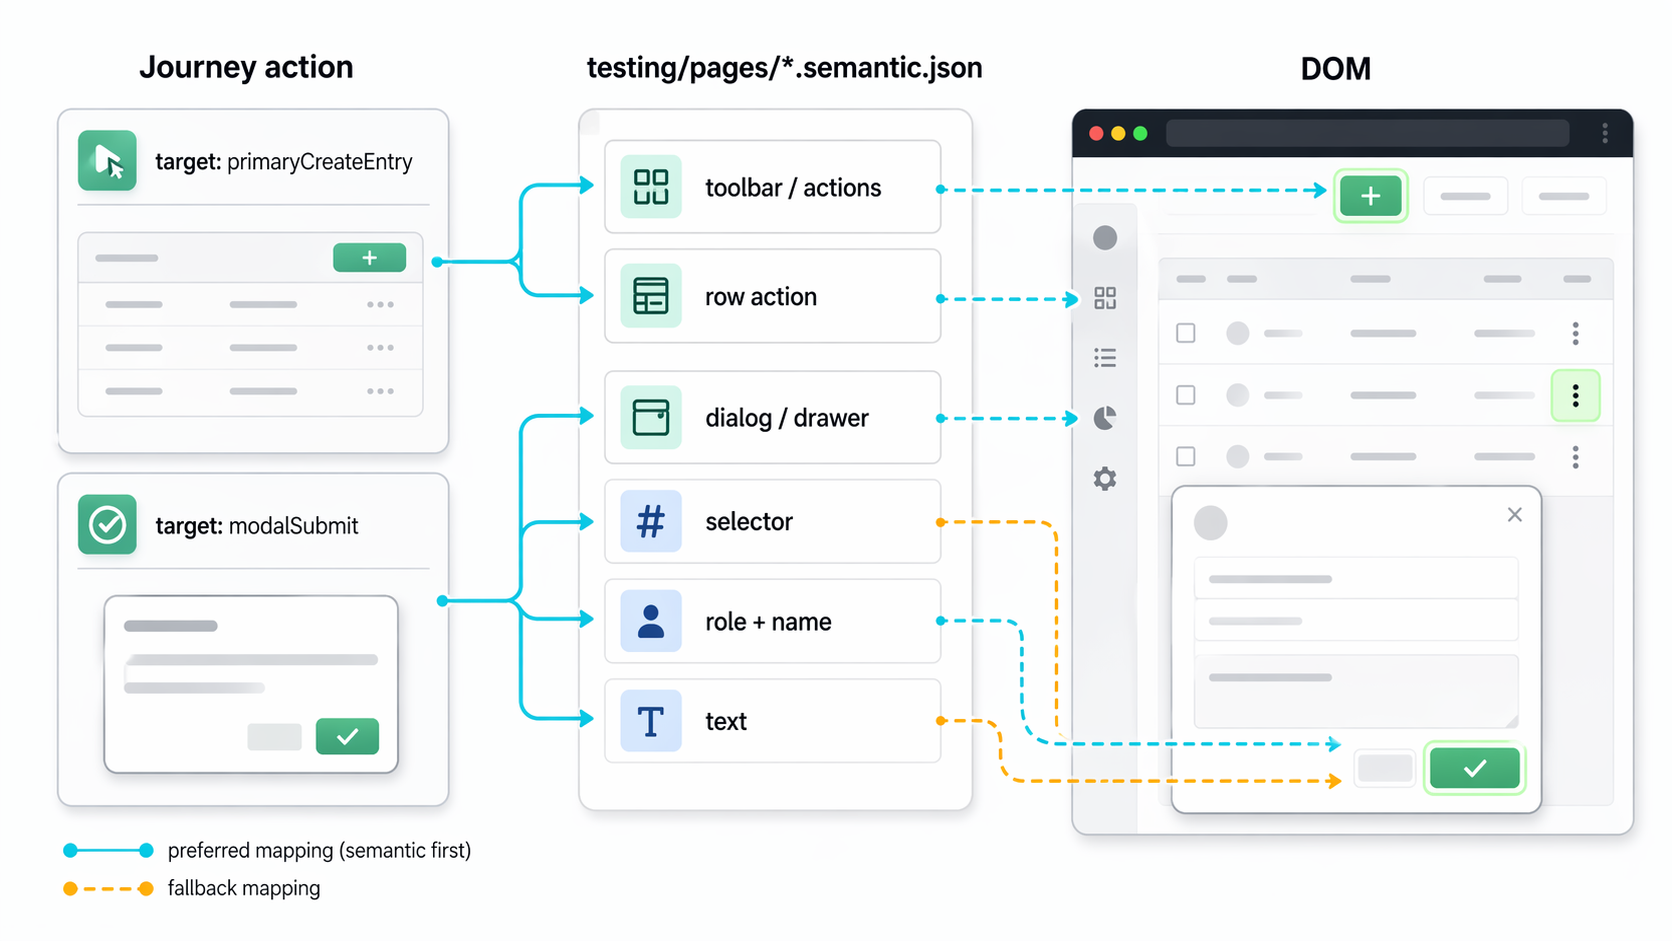
这层的价值是把“业务动作”和“DOM 定位”拆开。页面结构变化时,优先改 semantic;业务验收意图变化时,再改 journey。
5. Journey Case 是怎么运行的
现在不需要用户手动传 appUrl。running-iteration-tests 会先启动本次测试专用 dev server,从 Bigfish 日志里解析端口,再拼出 APP_URL=http://localhost:<port>/inst。
在 iteration-implementation 的循环里,通常跑单个 task:
if JOURNEY_ENV="$(bash .claude/skills/running-iteration-tests/scripts/start-dev-server.sh activity-manage-1.0)"; then
  eval "$JOURNEY_ENV"
else
  bash .claude/skills/running-iteration-tests/scripts/stop-dev-server.sh
  exit 1
fi

tnpm run test:journey -- \
  --iteration activity-manage-1.0 \
  --task ACT-003 \
  --app-url "$APP_URL"

bash .claude/skills/running-iteration-tests/scripts/stop-dev-server.sh
如果要做整迭代回归,就不传 --task:
if JOURNEY_ENV="$(bash .claude/skills/running-iteration-tests/scripts/start-dev-server.sh activity-manage-1.0)"; then
  eval "$JOURNEY_ENV"
else
  bash .claude/skills/running-iteration-tests/scripts/stop-dev-server.sh
  exit 1
fi

tnpm run test:journey -- \
  --iteration activity-manage-1.0 \
  --app-url "$APP_URL"

bash .claude/skills/running-iteration-tests/scripts/stop-dev-server.sh
执行链路是:
running-iteration-tests
  -> start-dev-server.sh
  -> 解析 APP_URL
  -> tnpm run test:journey -- --iteration <iteration> [--task <taskId>] --app-url "$APP_URL"
  -> testing/scripts/test-journey.ts
  -> testing/runtime/testJourney.ts
  -> testing/results/<iteration>/<taskId>.json
runtime 主要做这些事:读 tasks.json、读 manifest.yaml、选择 journey、加载页面语义配置、执行 flow、捕获请求、写 testing/results。
如果传了 --task,runtime 只执行这个 task 关联的 journey;如果没传 --task,就按 tasks.json 顺序串行执行整个迭代。这里不并发,因为 journey 会操作同一个浏览器页面,并行容易污染状态。
6. 为什么它不是传统 E2E
这套方案容易被误解成“换一种方式写 Playwright”。但它和传统 E2E 的重心不一样。
传统 E2E 通常从执行脚本出发:打开页面、定位元素、点击、等待、断言。它很适合覆盖真实浏览器行为,也适合验证复杂交互、跨页面链路、布局状态和一些只能在浏览器里观察的问题。
Journey Case 更靠前一层。它先把业务验收抽象成标准资产:这个 slice 有哪些主路径和分支路径,应该发哪些请求,不应该发哪些请求,payload 至少要包含哪些字段,操作后页面应该出现什么业务结果。至于这些动作底层是不是由 Playwright 执行,是 runtime 的实现细节。
所以这里不是要放弃传统 E2E。相反,传统 E2E 仍然值得支持,我们也在尝试把它纳入同一套迭代测试体系里:test:e2e 负责更贴近浏览器行为的用例,test:journey 负责更贴近业务验收资产的用例。
真正要标准化的不是某个测试命令,而是验收资产本身。任务拆出来的时候,验收也同步拆出来;代码实现完以后,Agent 和人都能沿着同一份 journey case 去判断这个 slice 到底有没有交付完成。